Відстежуючи сліди штучного інтелекту: мета та способи, якими індустрія навчилася розпізнавати контент, створений за допомогою генеративних технологій.
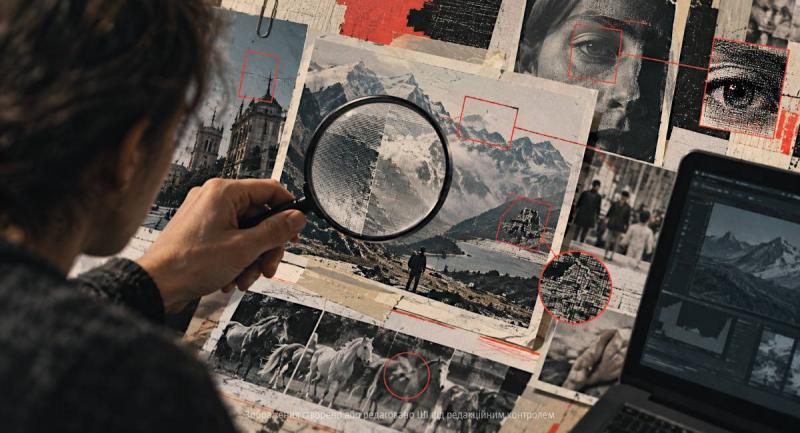
ШІ-компанії додаватимуть вбудовані універсальні мітки в згенерований ними контент. Це допоможе в роботі фактчекерів та антиплагіат-систем.
Улітку 2026 року питання маркування контенту, створеного за допомогою штучного інтелекту, перестало бути лише експериментальним завданням і стало обов'язковим регуляторним вимогою, принаймні в межах Європейського Союзу. 2 серпня в ЄС набули чинності нові положення статті 50 Акта про штучний інтелект (AI Act), що зобов'язують постачальників генеративних систем штучного інтелекту позначати результати своєї діяльності.
Того ж тижня компанія Anthropic повідомила, що її штучний інтелект, чатбот на ім'я Claude, інтегрує невидимі "водяні знаки" (універсальні маркери) або метадані в контент, який він генерує — текст чи файли, створені за допомогою ШІ.
Ці дві події, які сталися практично одночасно, ілюструють, як підходи до визначення ШІ-контенту еволюціонують в двох напрямках: від технічних міток, що їх впроваджують самі розробники, до обов'язкових норм, закріплених законодавством. Ринок логічно перейшов до тексту як до наступного виду контенту, що вимагає маркування та здатності розрізняти його від продукції, створеної людиною, оскільки подібні практики вже були запроваджені для зображень, аудіофайлів та відео.
Чому важливо звертати увагу на тексти, створені штучним інтелектом?
Популярність інструментів штучного інтелекту невпинно зростає з кожним місяцем. Це призводить до збільшення обсягу контенту, створеного за допомогою ШІ. Відтак, важливість його ідентифікації стає критичною, оскільки вона безпосередньо пов'язана з довірою до джерел інформації. Коли люди не здатні відрізнити контент, створений штучним інтелектом, від творів людей, виникає ризик непорозумінь щодо авторства журналістських зображень, доказів у судових справах або політичних звернень. Наслідки можуть бути серйозними: фальшиве зображення може піддати сумніву справжню журналістську діяльність, сфабриковані докази можуть вплинути на судові рішення, а згенероване політичне звернення може змінити думку виборців про кандидата. У світі, де такий контент стає все більш поширеним, питання його походження стає питанням відповідальності та довіри до інформації в цілому.
Розуміти, хто автор контенту, який ми зустрічаємо онлайн, -- лише одна із потреб сучасності. Друга причина практичніша й стосується освіти та публічної комунікації. Виявлення академічного плагіату, модерація платформ, робота фактчекерів і регуляторів потребують інструмента, який допоможе відрізнити текст, створений "машиною", від документу, написаного людиною. Такі універсальні мітки, що свідчать про ШІ-походження (або "мітки штучності"), допоможуть уникнути помилок у роботі ШІ-детекторів, з якими зіткнулась, до прикладу, вища освіта у намаганні дізнатися, чи писали студенти свої роботи за допомогою ШІ.
Відеоконтент як тестовий майданчик для визначення слідів ШІ
Практика маркування синтетичного контенту спочатку сформувалася передусім навколо відео та зображень. Спочатку індустрія розробила так звані "мітки штучності" саме для такого контенту, а платформи для його розміщення запровадили вимоги обов'язковості цих позначок.
У 2024 році YouTube ввів нові вимоги для творців відео, які зобов'язують їх вказувати на наявність реалістичного контенту, створеного або значно модифікованого за допомогою штучного інтелекту.
Meta впровадила маркування AI info для зображень, відео та аудіофайлів.
У 2024 році TikTok впровадив автоматичну маркування контенту, створеного за допомогою штучного інтелекту, ставши першим відеосервісом, який реалізував технологію Content Credentials відповідно до стандарту C2PA.
Цей підхід базується на стандарті C2PA, який визначає походження цифрового контенту. Цей галузевий стандарт був ініційований у 2021 році такими компаніями, як Adobe, Microsoft, BBC, Intel та іншими. C2PA документує походження файлів та їх зміни за допомогою вбудованих метаданих, а не через видимі водяні знаки.
Для відео й зображень така модель виявилася практичнішою. Виробник ШІ-інструменту може додати до файлу метадані про його походження, а платформа, яка публікує контент, -- прочитати ці дані й у своєму інтерфейсі показати користувачеві спеціальну помітку: "мітку штучності". Саме так працюють, зокрема, C2PA Content Credentials у TikTok. Але з текстом ця схема складніша: його легко скопіювати, перефразувати чи відредагувати, втративши початкові метадані. Тому для текстового контенту ця модель виявилася значно складнішою, тож саме він значно пізніше став окремим напрямом дискусії про маркування ШІ-контенту.
Як функціонує система виявлення штучного інтелекту від Anthropic
Компанія Anthropic стала першою організацією, яка представила своє власне рішення для виявлення текстів та файлів, створених за допомогою штучного інтелекту. Її розробка має різні методи маркування для тексту та файлів. Для текстових матеріалів Anthropic використовує підхід, схожий на технологію SynthID-Text від Google DeepMind: це невидимий водяний знак для ШІ-генерованого тексту, який інтегрується прямо під час створення. Під час генерації система вбудовує в текст невидимий сигнал, що може бути виявлений за допомогою спеціального детектора. На відміну від метаданих, цей знак залишається навіть після копіювання тексту та частково зберігається після редагування.
Для файлів форматів PNG, JPG і SVG ШІ-чатбот Claude додає до файлу метадані за стандартом C2PA, які фіксують, що документ був створений або оброблений за допомогою Claude. Оскільки C2PA -- відкритий стандарт, цю мітку можуть зчитувати не лише інструменти Anthropic, але й будь-який сервіс або програма, що підтримує цей стандарт. Наприклад, якщо такий файл завантажити на інший сервіс -- від відеохостингу до системи перевірки академічних робіт, -- він може прочитати метадані, визначити, що файл створив або обробив Claude, і використати цю інформацію для власних рішень. Наприклад, показати мітку про ШІ-контент у соцмережі чи врахувати походження файлу під час перевірки академічної роботи.
Ця мітка доступна не лише для ШІ-чатбота Claude, але й для інших продуктів компанії Anthropic, таких як Claude Code або Cowork. Однак, представники компанії визнають, що C2PA-мітка може бути втраченню під час процесів конвертації, повторного збереження або при створенні скриншотів.
На даний момент текстовий водяний знак Claude може використовуватися лише певними організаціями. Anthropic пропонує приватний доступ до цього інструменту регуляторам, медіа, фактчекерам, науковцям та іншим групам, з наміром поступово розширити коло користувачів.
А користувачі проти
Інформація про введення спеціальних міток для контенту, створеного штучним інтелектом, викликала неоднозначну реакцію серед деяких користувачів. Найактивніші дискусії з цього приводу проходили на платформі Reddit.
До прикладу, в гілках r/artificial і r/Anthropic водяні знаки називали інструментом переслідування. Основним аргументом юзерів на підтвердження цієї точки зору стало те, що постраждати від такої перевірки можуть не ті, хто видає текст ШІ за власний, а користувачі, які застосовують Claude як допоміжний інструмент: студент, що просить ШІ-чатбот покращити свою роботу, журналіст, який підсумовує стенограму, чи письменник, якому потрібен синонім. Водночас досвідчені користувачі можуть спробувати обійти маркування, перефразувавши текст або змінивши його формат. Один із дописувачів назвав водяний знак "цифровим татуюванням на лобі".
Інша лінія критики стосується самої компанії Anthropic. Деякі вважають маркування лицемірним, оскільки мовні моделі навчалися на даних, отриманих без згоди правовласників. Встановлення водяного знака на результат, за який користувач доклав зусиль, надаючи інструкції, контекст і безліч правок, критики сприймають як надмірну претензію інструмента на авторство. Проте частина коментаторів підтримує маркування: якщо основна частина тексту була створена Claude, користувач не повинен видавати його за цілком власну роботу.
Дискусія на Reddit підкреслює слабкість самої концепції маркування текстів, створених штучним інтелектом. Сприйняття таких матеріалів залежить від того, чи відчуває користувач, що цей контент є "його власним".
Які вимоги висуває європейський Акт про штучний інтелект, і яким чином Китай та США здійснюють регулювання контенту, пов'язаного з ШІ?
Стаття 50 європейського Акту про штучний інтелект визначає чотири ключові вимоги щодо прозорості контенту, створеного за допомогою ШІ. Провайдери систем, які взаємодіють з користувачами, зобов'язані інформувати їх про те, що вони мають справу з контентом, генерованим штучним інтелектом. Крім того, сервіси, що створюють або модифікують контент, повинні маркувати його у форматі, зручному для машинного зчитування, що дозволяє іншим IT-системам його обробляти. Але це ще не все: організації, які застосовують системи для розпізнавання емоцій або біометричної класифікації, повинні інформувати людей про їхнє використання. Аналогічні позначки отримають дипфейки та текст, згенерований на теми, що мають суспільну вагу.
Основні вимоги європейського Акта про ШІ почали діяти 2 серпня 2026 року. Проте генеративні ШІ-системи, які працювали на ринку до цієї дати, отримали час до 2 грудня 2026 року на запровадження машинозчитуваних міток про ШІ.
Не лише Європейський Союз втілює подібні зміни в процесі ідентифікації контенту, створеного штучним інтелектом. Ще у 2025 році Китай запровадив обов'язкове маркування ШІ, поєднуючи видимі позначки з прихованими технічними ідентифікаторами. Платформи зобов'язані перевіряти свій контент на наявність таких міток і вживати заходів у разі виявлення порушень. У лютому 2026 року китайський регулятор оголосив, що генеративні платформи штучного інтелекту вже промаркували понад 150 мільярдів одиниць ШІ-контенту, тоді як соціальні мережі додатково маркували понад 220 мільйонів. Таким чином, китайська модель відрізняється не лише більш детальними технічними вимогами, але й значно суворішими заходами правозастосування.
Сполучені Штати обрали інший курс. В країні немає єдиного федерального стандарту для маркування контенту, створеного за допомогою штучного інтелекту; основні вимоги формуються на рівні окремих штатів. Каліфорнія запровадила власні правила щодо прозорості генеративного ШІ, включаючи вимоги до видимих та прихованих позначок, а також інструменти для перевірки походження контенту. У той же час, політика адміністрації Трампа на федеральному рівні була націлена на розробку єдиного підходу та зменшення регуляторних розбіжностей між штатами. Таким чином, нинішня модель в США залишається значно менш уніфікованою в порівнянні з європейською.
Внаслідок цього в глобальному контексті виникло три різні методики для виявлення контенту, створеного штучним інтелектом.
Європейський Союз створює нову структурну модель прозорості, яка передбачає чіткий розподіл обов'язків між постачальниками та підприємствами, що використовують штучний інтелект.
Китай інтегрує точні технічні стандарти з суворим наглядом за їх дотриманням.
* Натомість підходи США залишаються фрагментованими між федеральною політикою та правилами окремих штатів.
Куди це прямує?
Наступний рік продемонструє, чи стане маркування контенту, створеного за допомогою штучного інтелекту, ефективним інструментом для перевірки, або ж залишиться лише формальністю в рамках регулювання. На даному етапі система маркування стикається з кількома практичними викликами.
Перший виклик -- це стандартизація систем ідентифікації ШІ. C2PA вже став основним стандартом для фіксації походження зображень і відео. Для тексту спільного відкритого стандарту поки немає: SynthID-Text та подібні технології залишаються рішеннями окремих компаній. Водночас навіть надійний водяний знак не гарантує збереження мітки про ШІ-походження, особливо після перекладу, перефразування чи суттєвого редагування.
Другий виклик стосується доступності перевірки. Зараз детектори водяних знаків в основному доступні лише розробникам, регуляторам та дослідникам, а звичайні користувачі не мають змоги самостійно встановити походження контенту. Крім того, сторонні сервіси наразі в основному додають позначки про використання штучного інтелекту лише для відео та зображень. Водночас з'являються нові інструменти, що дозволяють обійти існуючі мітки, тому боротьба між їх нанесенням і видаленням, ймовірно, буде лише загострюватися.
Медіа стикається з новим викликом – надмірним маркуванням. Європейські мовники вже висловлюють занепокоєння, що занадто широке визначення контенту, створеного за допомогою штучного інтелекту, може призвести до маркування матеріалів, де ШІ виступає лише як допоміжний інструмент для журналістів. Якщо таке маркування буде використовуватися занадто часто або неправильно, воно може втратити свою інформаційну цінність.
Тому запровадження систем ідентифікації ШІ на даному етапі -- лише початок. Надалі головним питанням буде не лише те, як маркувати ШІ-контент, а як зробити це так, щоб мітці можна було довіряти. C2PA, водяні знаки й інші технології можуть підтверджувати походження контенту, але не здатні самі по собі визначити, наскільки цей контент достовірний та ким і з якою метою створений. Саме на цій межі регулювання ШІ стикається з головною проблемою медіа -- довірою.